Avanço do hardware de inferência promete transformar a tecnologia em 2026
Tema central identificado: Revolução no hardware para inferência de IA – desafios técnicos, inovações arquiteturais e novas soluções para acelerar o uso prático de grandes modelos de linguagem.
Resumo jornalístico:
A explosão do uso prático de grandes modelos de linguagem (LLMs) está impulsionando uma revolução silenciosa no hardware dedicado à inferência de inteligência artificial. Se antes o foco era treinar modelos cada vez maiores, agora a principal preocupação das empresas é como executar esses modelos rapidamente e em larga escala, respondendo a demandas que vão desde geração de textos até agentes autônomos que operam 24 horas por dia.
O processo de inferência, responsável por gerar respostas a partir de modelos já treinados, apresenta desafios computacionais distintos do treinamento. Enquanto GPUs tradicionais dominam a etapa inicial (prefill), onde múltiplos dados são processados em paralelo, o gargalo surge na fase de geração sequencial de tokens (decode), exigindo acesso rápido e constante a enormes volumes de memória. O resultado é que parte significativa do poder computacional das GPUs fica ociosa, limitada pela largura de banda da memória disponível.
Para superar esses obstáculos, startups e gigantes do setor estão apostando em arquiteturas inovadoras. Soluções como o empilhamento vertical de aceleradores sobre chips DRAM (caso da d-Matrix) ou interfaces proprietárias que conectam grandes volumes de memória comum (Majestic Labs) buscam aproximar computação e armazenamento, reduzindo atrasos e custos. Paralelamente, novos formatos numéricos de baixa precisão, como os padrões NVFP4 e MXFP4 para quantização em 4 bits, permitem comprimir modelos sem perda significativa de desempenho, triplicando a eficiência em alguns testes.
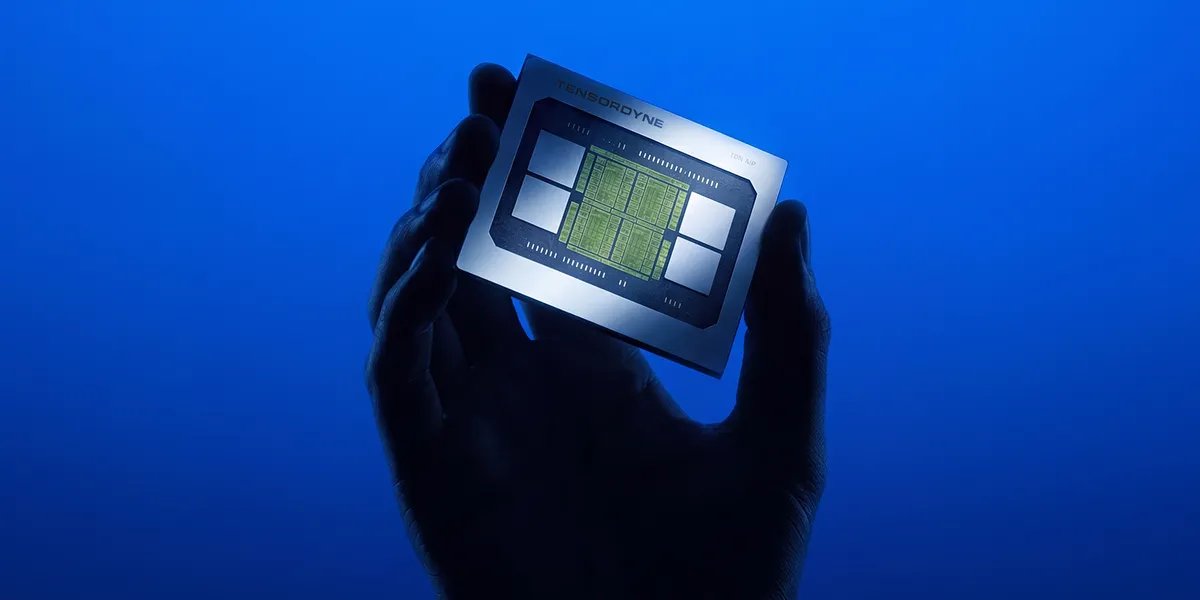
A tendência aponta para sistemas híbridos que combinam diferentes tipos de chips — GPUs potentes para prefill e aceleradores especializados com grande capacidade de memória SRAM ou DRAM para decode. Exemplos incluem o uso conjunto dos chips Trainium da Amazon com as gigantescas wafers da Cerebras ou a integração dos LPUs Groq 3 pela Nvidia. Além disso, startups como Tensordyne e Etched exploram abordagens radicais, desde sistemas baseados em logaritmos até chips desenhados sob medida para cálculos do tipo transformer.
Com a demanda por inferência crescendo exponencialmente e aplicações cada vez mais diversas, especialistas acreditam que não haverá uma solução única vencedora. Assim como ocorreu com os processadores tradicionais, a evolução do hardware para IA deve avançar em múltiplas frentes ao mesmo tempo — consolidando um novo capítulo na história da computação aplicada à inteligência artificial.
Fonte original: spectrum.ieee.org
Acessar publicação original
Resumo editorial criado automaticamente pela Eletrônica Americana com base em fontes internacionais públicas, com finalidade informativa.
Além de se manter informado, você pode aprofundar seus conhecimentos em nossos guias de compra, com informações e comparações que ajudam na escolha de produtos. Para conhecer características, especificações, pontos positivos e limitações, confira nossos reviews de produtos, elaborados com base em informações oficiais, dados públicos e avaliações de consumidores. Você também pode acompanhar nossa seleção de ofertas e descontos disponíveis nas principais lojas.